软件工程方法
本章开启了本书最后一部分,也就是关于软件工程的部分。这一部分会讨论软件工程方法、代码效率、测试、调试、设计技术、设计模式,以及如何面向多个平台开发。
你刚开始学编程时,节奏大概率完全由自己掌控。你可以把事情拖到最后一刻,也可以在实现过程中大幅推翻原有设计。但在专业软件开发环境里,程序员通常没有这种自由。即便是最开明的工程经理,也会承认流程总得有一些。今天,理解软件工程流程的重要性,已经不亚于理解如何写代码本身。
本章会概览几种不同的软件工程方法。我不会对其中任何一种做特别深入的展开——因为关于软件工程流程,本来就已有大量优秀书籍。我的目标,是用比较宏观的方式介绍若干不同类型的流程,帮助你看清它们之间的差异与取舍。我会尽量避免直接推崇或否定任何某一种方法。相反,我更希望你在了解了多种方法各自的 tradeoff 之后,能够为你自己和团队组合出一套真正适用的流程。无论你是独自接项目的 contractor,还是身处一个横跨数个大洲、拥有数百名工程师的大团队,理解不同的软件开发方式,都会在日常工作中持续帮助到你。
本章最后还会讨论 version control system。它让你可以方便地管理 source code,并跟踪其历史记录。对任何公司来说,version control system 都是必需品,否则 source code 维护很快就会变成噩梦。即便是单人项目,我也强烈建议你使用这样的系统。
为什么需要流程
Section titled “为什么需要流程”软件开发史几乎到处都是失败项目的故事。从预算超支、营销失败的 consumer application,到声势浩大却最终翻车的操作系统,似乎软件开发的任何领域都逃不开这种趋势。
即便软件最终真的交付给了用户,bug 也已经普遍到让终端用户不得不习惯不断接收更新与补丁。有时,软件根本做不到它本应完成的任务;有时,它虽然“能跑”,却并不按用户预期那样工作。所有这些问题都指向同一个事实:写软件真的很难。
你可能会好奇:为什么软件工程看起来比其他工程学科更容易失败?例如,虽然汽车也会有缺陷,但你很少看到它们因为 buffer overflow 突然熄火然后要求 reboot(当然,随着越来越多汽车部件变成 software-driven,这种玩笑也不再那么离谱)。你的电视可能不完美,但你也不用为了看第 6 频道,先升级到 2.3 版。
是不是其他工程学科只是比软件开发更成熟?土木工程师之所以能造出可靠桥梁,是不是因为桥梁建造已经有了悠久积累?化学工程师能成功制备化合物,是不是因为前几代早已把大多数 bug“调通”了?软件工程到底是“太新了”,还是说它本来就是一种性质不同的学科,而这种学科的内在属性就注定它更容易产生 bug、产出不好用的结果,甚至酿成注定失败的项目?
看起来,软件工程的确有些不同。首先,计算机技术变化极快,这给软件开发过程本身带来了很大不确定性。即使在你的项目期间没有发生什么颠覆性技术突破,仅仅 IT 行业自身的迭代速度,就足以制造各种问题。与此同时,软件常常还必须快速开发,因为竞争非常激烈。
软件开发的进度也往往难以预测。只要一个棘手 bug 就可能花掉几天、甚至几周,精确排期几乎不可能。更糟的是,即使一切看起来都在按计划推进,产品定义仍然经常变化——这通常被称为 feature creep 或 scope creep。如果不加控制,这种 scope creep 最终会直接导致软件膨胀。
软件通常也极其复杂。我们没有简单而精确的方法来证明一个程序完全没有 bug。如果一份混乱或有缺陷的代码在多个版本中被持续维护,它很可能在数年内都持续拖累软件本身。很多软件系统复杂到,当团队发生人员变动时,谁都不想靠近那些乱成一团的 legacy code。于是,项目便陷入无尽的 patch、hack 和 workaround 循环。
当然,普通商业风险在软件行业同样存在。市场压力、沟通不畅都会制造麻烦。很多程序员都想远离办公室政治,但开发团队与产品/市场团队之间出现紧张关系,其实一点也不罕见。
所有这些不利于软件工程的因素,都说明我们需要某种流程。软件项目体量大、复杂度高、节奏又快。如果想避免失败,工程团队就必须采用某种系统,来驾驭这个难以控制的过程。
设计优雅、代码干净、可维护性强的软件,当然是可以做出来的。我坚信这一点。但它需要每一位团队成员持续投入努力,也需要真正遵守合适的软件开发流程与实践。
软件生命周期模型
Section titled “软件生命周期模型”软件复杂性并不是什么新问题。几十年前,人们就已经意识到:需要某种形式化流程。于是,围绕 software life cycle 出现了多种建模方式,它们试图通过定义“从最初想法到最终产品”的一系列步骤,为软件开发这件混乱的事带来一点秩序。这些模型经过多年演进,如今仍在深刻影响大量软件开发工作。
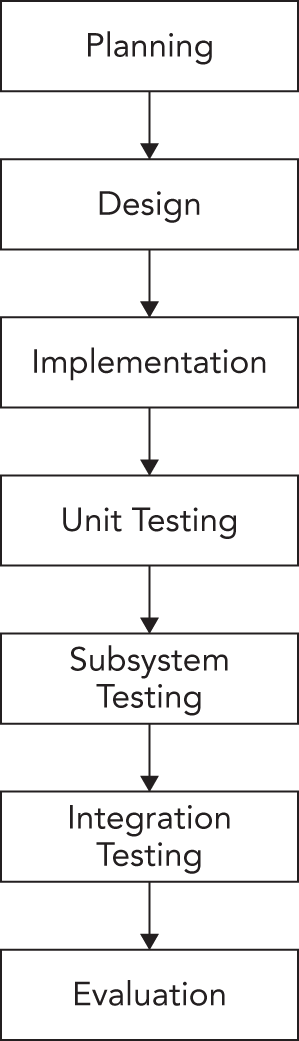
软件领域最经典的 life cycle model 之一,就是 Waterfall Model。它背后的基本思想是:软件的构建几乎可以像照着菜谱做菜一样。只要按顺序完成一组既定步骤,最终就能得到一个很棒的巧克力蛋糕——或者,在这里,是一个程序。每一个阶段都必须先完整结束,下一阶段才能开始,如图 28.1 所示。之所以叫 waterfall,是因为整个过程像瀑布一样,只能一层一层向下流。
[^FIGURE 28.1]
这个过程从正式 planning 开始,其中包括收集一份尽可能完整的 requirements 列表。这个列表定义了产品在 feature 上应达到怎样的完整度。requirements 越具体,项目成功的概率通常就越高。下一步是设计软件,并把设计详细规格化。和 requirements 阶段一样,design 阶段也越具体越好,因为越具体,就越有机会成功。所有设计决策通常都在此时做出,往往还会包括 pseudo-code,以及需要编写的具体 subsystem 定义。各 subsystem 的负责人会理清自己的代码如何协作,团队则就 architecture 的细节达成一致。接下来才进入 implementation。由于 design 已经被完整规定,代码就必须紧贴设计实现,否则各部分最终就无法拼合起来。最后四个阶段则留给 unit testing、subsystem testing、integration testing 和 evaluation。
Waterfall Model 的主要问题在于:在真实实践中,如果不提前探一探下一阶段,几乎不可能真正完成当前阶段。你不写出至少一点点代码,设计就不可能真的定下来。再者,一旦测试暴露出 bug,你就不得不沿着“瀑布”往回爬,重新写代码——不管你的模型愿不愿意承认这一点。
Waterfall Model 后来也被发展出多种不同变体。例如,有些流程会在正式收集 requirements 之前先加入一个 feasibility 阶段,通过实验先判断方案是否可行。
瀑布模型的优点
Section titled “瀑布模型的优点”Waterfall Model 的价值在于它的简单。你自己,或者你的经理,也许曾在项目里采用过这种方式,只是没有正式给它命名而已。它的底层假设是:只要每个步骤都尽可能完整、准确地完成,那么后续步骤就会走得顺畅。只要第一步把所有 requirement 都仔细规定清楚,第二步又把所有设计决策和设计问题都处理妥当,那么第三步的 implementation 理应只是把设计翻译成代码这么简单。
正因为简单,基于 Waterfall Model 的项目计划看起来通常非常有条理,也比较容易管理。每个项目都会以同样的方式开始:详尽列出所有必须具备的 feature。例如,使用这种方法的 manager 可以要求:在 design 阶段结束时,每一个负责 subsystem 的工程师都必须提交正式的 design document 或 functional subsystem specification。对 manager 来说,这样做的好处在于:通过让工程师尽早把 requirement 和 design 都写明,风险(至少在理论上)会被压低。
从工程师视角看,Waterfall Model 强迫你把主要问题尽量前置解决。所有工程师在真正开始写大量代码之前,都必须先理解项目并完成 subsystem 设计。理想情况下,这意味着代码只需要写一次,而不是在最后发现模块拼不上时再仓促打补丁或大面积重写。
对 requirement 非常明确的小型项目而言,Waterfall Model 其实可以工作得相当不错。尤其是在 consulting 场景下,它还有一个明显优势:项目一开始就能定义清晰的成功指标。通过形式化 requirement,consultant 更容易准确交付客户真正想要的东西,而客户也会被迫更明确地说明项目目标。
瀑布模型的缺点
Section titled “瀑布模型的缺点”在许多组织里,以及几乎所有现代软件工程教材中,Waterfall Model 都已经失宠。批评者认为,它的根本前提——即软件开发任务会以离散、线性的方式发生——本身就站不住脚。Waterfall Model 通常不允许向后回退。但不幸的是,在今天的许多项目中,新的 requirement 往往会在开发过程中不断冒出来。比如,某个潜在客户会临时提出一个对于成交至关重要的新 feature;又或者,竞争对手发布了一个新 feature,迫使你也必须跟上。
另一个缺点是:Waterfall Model 一边试图通过“尽早、尽正式地做决策”来降低风险,一边却又可能把真正的风险藏起来。例如,在 design 阶段,一个重大设计问题可能根本没被发现、被轻描淡写地带过、被遗忘,甚至被有意回避。等到 integration testing 最终把这种不匹配暴露出来时,团队就只能重新“逆流而上”,回头修补之前的问题。瀑布流程中任何一个环节犯的错误,都很可能在最后阶段引发延误。而早期发现问题,往往非常困难,也并不常见。
如果你真的要使用 Waterfall Model,通常需要借鉴其他方法的思路,让它变得更灵活一些。
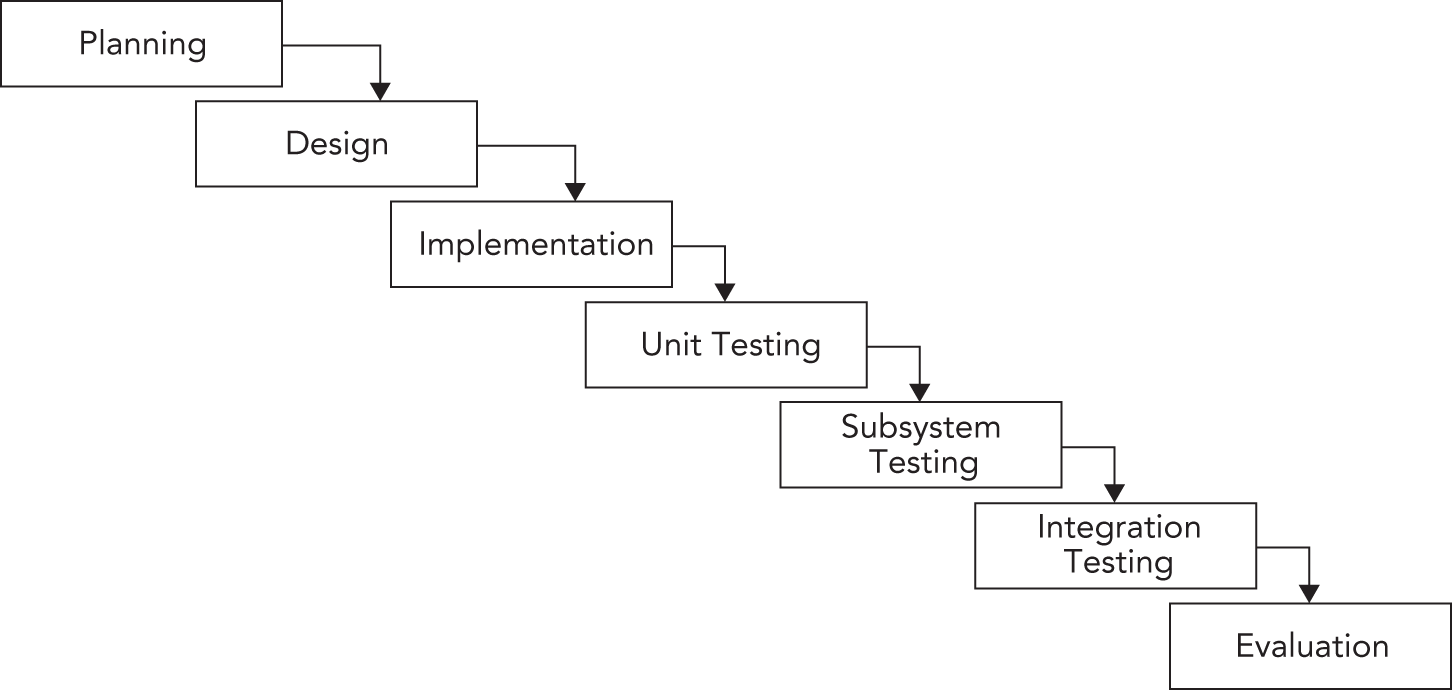
Waterfall Model 的很多改进形式都已经被系统化,其中一种就叫 Sashimi Model。它最重要的改进,是引入了“阶段之间允许重叠”这一概念。之所以叫 sashimi model,是因为 sashimi 这道日本料理本身就是一片片鱼肉彼此覆盖、相互叠压。虽然该模型仍然强调严格的 planning、design、coding 和 testing 流程,但相邻阶段之间允许部分重叠。图 28.2 展示了 Sashimi Model 的一个例子,你可以看到阶段之间的重叠关系。重叠意味着:两个阶段中的活动可以同时发生。这实际上承认了一个事实——某个阶段往往不可能在完全不碰下一个阶段的前提下,就被彻底完成。
[^FIGURE 28.2]
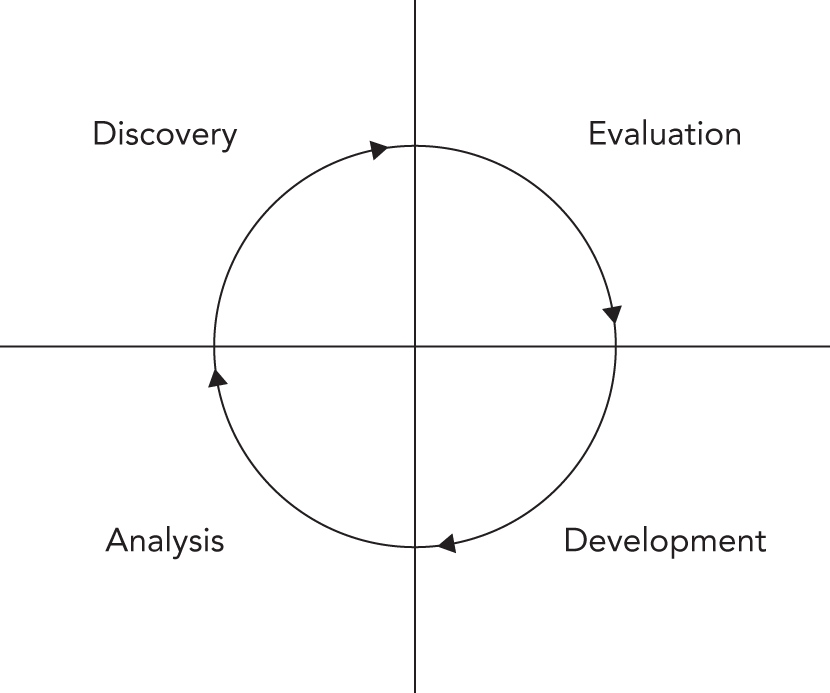
Spiral Model 由 Barry W. Boehm 于 1986 年提出,是一种 risk-driven 的软件开发流程。后来又衍生出多种变体,统称为 spiral-like models。本节讨论的模型,属于一大类被称为 iterative processes 的技术。它背后的核心思想是:即使某件事出错了,也没关系,因为你可以在下一轮 iteration 中修正它。图 28.3 展示了沿着这种 spiral-like model 完成一次循环时会经历的内容。
这个模型的 phases 与 Waterfall Model 的步骤有些相似。discovery phase 会识别 requirement、确定目标、评估各种 alternative(设计备选方案、代码复用、购买第三方库等),并确定约束条件。evaluation phase 会对 implementation alternative 做评估、分析风险,并考虑 prototype 的选择。在 spiral-like model 中,evaluation phase 尤其强调对风险的识别和消解。那些被认为风险最高的任务,会优先在当前 spiral cycle 中落地实现。也就是说,development phase 要做什么,是由 evaluation phase 中识别出的风险来决定的。比如,如果 evaluation 发现某个 algorithm 风险极高,甚至可能根本无法实现,那么当前 cycle 中 development 的主要任务,就会变成建模、构建并测试这个 algorithm。第四个 phase 留给 analysis 与 planning。团队会根据当前 cycle 的结果,制定下一轮 cycle 的计划。
[^FIGURE 28.3]
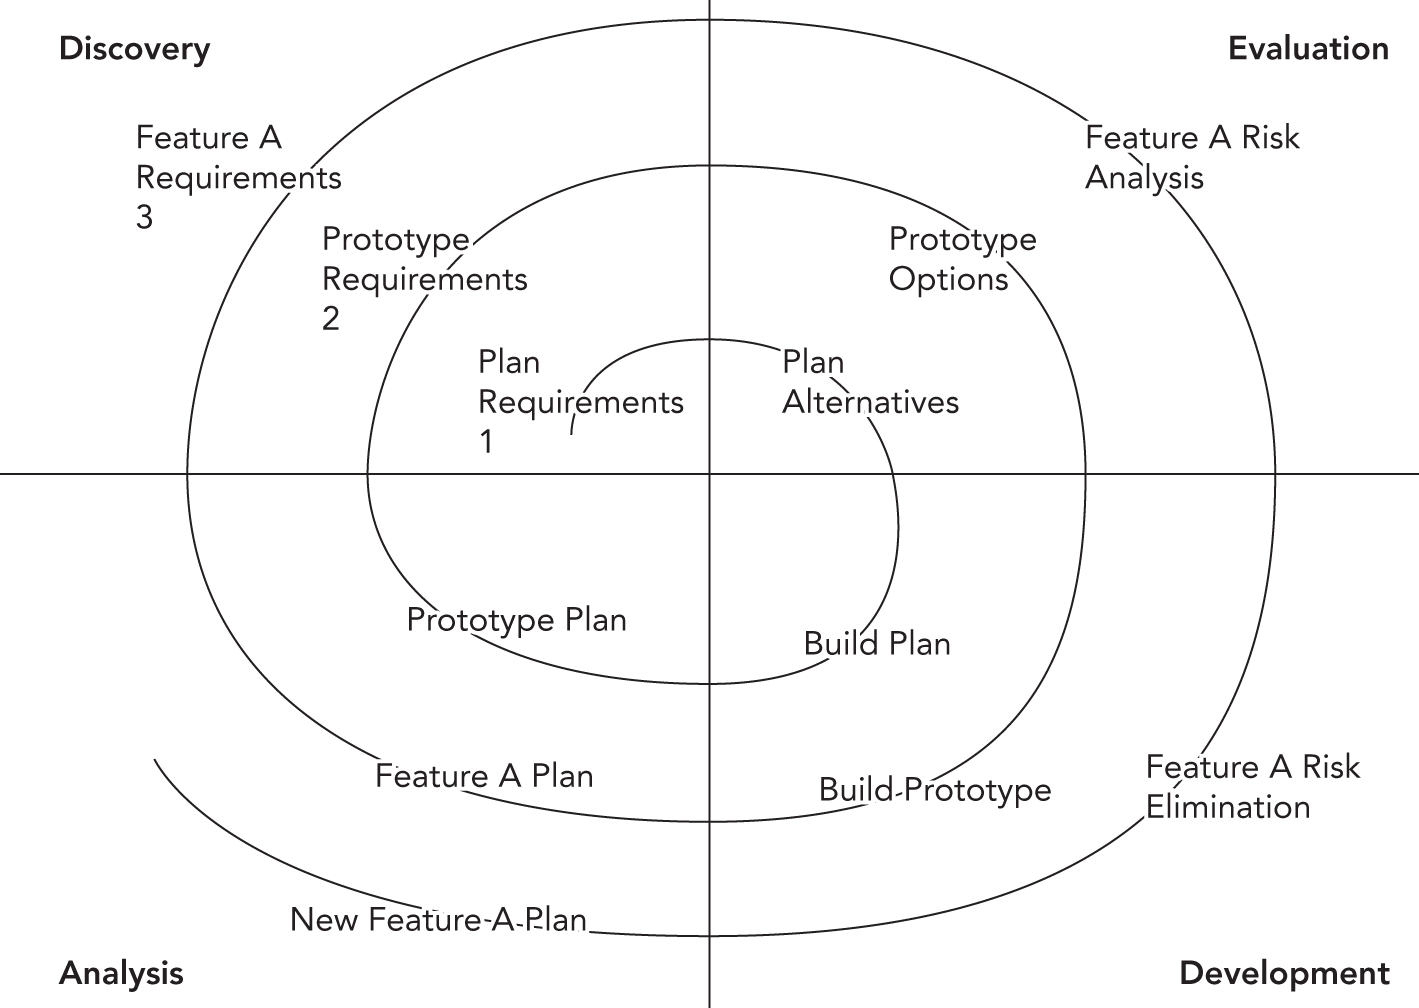
图 28.4 展示了在一个 operating system 开发过程中,沿 spiral 走过三个 cycle 的示例。第一个 cycle 产出的是包含主要 requirement 的计划;第二个 cycle 产出的是展示 user experience 的 prototype;第三个 cycle 则实现了一个被判定为高风险的 component。
[^FIGURE 28.4]
螺旋式模型的优点
Section titled “螺旋式模型的优点”可以把 spiral-like model 看成是:把 Waterfall Model 中最有价值的那一部分,与迭代方法结合起来。图 28.5 展示了一种把 waterfall process 改造成允许迭代的 spiral-like process 的思路。Waterfall Model 的两大问题——隐藏风险,以及过于线性的开发路径——都可以通过迭代 cycle 得到缓解。
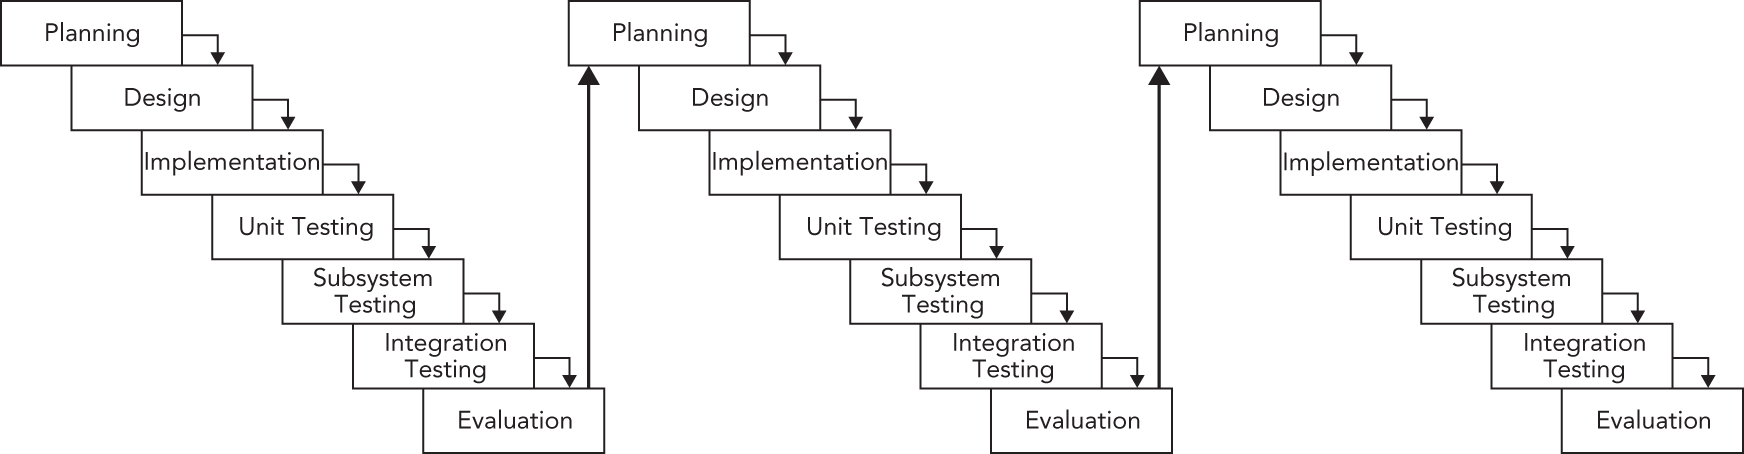
[^FIGURE 28.5]
另一个重要优点,是优先处理风险最高的任务。通过把风险前置,并承认新情况随时都可能出现,spiral-like model 可以避免 Waterfall Model 中那种“把定时炸弹埋到最后才引爆”的局面。一旦出现意外问题,团队仍可以沿用同样的四阶段方法去处理它。
这种迭代方式也允许吸收 tester 的反馈。例如,可以先发布一个较早版本,供内部甚至外部进行评估。tester 可能会指出:某个 feature 缺失了,或者某个已有 feature 的行为不符合预期。spiral-like model 内部自带一种机制,可以对这类输入作出反应。
最后,由于每个 cycle 之后都会再次分析并重新形成设计,design-then-implement 这种方式在实践中的困难也大幅减轻。随着 cycle 不断推进,团队会对整个系统积累更多认知,而这些新认知又可以反过来影响后续 design。
螺旋式模型的缺点
Section titled “螺旋式模型的缺点”spiral-like model 的主要缺点,是很难把每一轮 iteration 的范围控制得足够小,从而真正得到迭代的收益。在最坏情况下,如果 iteration 划得太长,spiral-like model 最终也可能退化成 Waterfall Model。不幸的是,spiral-like model 只能“描述” software life cycle,而不能直接规定“该如何把某个具体项目拆成一轮轮 cycle”,因为这种拆分高度依赖具体项目本身。
其他可能的缺点,还包括:每个 cycle 都重复四个 phase 所带来的流程开销,以及协调不同 cycle 的难度。实际执行时,想把所有团队成员恰好在合适时间聚到一起讨论 design,并不容易。如果不同团队同时在做产品的不同部分,它们很可能处在平行推进的不同 cycle 中,这就容易失去同步。例如,在开发一个 operating system 时,user interface 团队可能已经准备进入 Window Manager cycle 的 discovery phase,而 core OS 团队却仍然还停留在 memory subsystem 的 development phase。
另一个问题,是项目整体的时间规划。如果你不断重复这四个 phase,那么到底什么时候该停下、结束项目?现实里,这通常还是要由 management 来决定终止条件,并为其给出理由。
为了解决 Waterfall Model 的缺陷,agile model 于 2001 年被正式提出,其核心文本就是著名的 Agile Manifesto。
敏捷软件开发宣言
Section titled “敏捷软件开发宣言”这份 manifesto 的全文(摘译自 http://agilemanifesto.org)如下:
我们一直在身体力行地开发软件,也在帮助他人如此实践,并由此不断发现更好的软件开发方式。在这个过程中,我们逐渐更加重视:
- 个体与互动 高于流程与工具
- 可工作的软件 高于面面俱到的文档
- 客户协作 高于合同谈判
- 响应变化 高于遵循计划
也就是说,右侧的事项并非没有价值,但与之相比,我们更重视左侧的事项。
从这份 manifesto 可以看出,agile 本身只是一个高层概念。它本质上是在告诉你:要让流程足够灵活,以便在开发过程中能方便地吸收客户的变化。Scrum 是最常见的 agile 软件开发 methodology 之一,下一节就会讨论它。
软件工程方法论
Section titled “软件工程方法论”software life cycle model 能够较好回答“我们下一步做什么?”这个问题,但通常并不能很好回答紧随其后的另一个问题:“具体该怎么做?”为了给“how”提供一些更可操作的答案,人们发展出了许多 software engineering methodologies,为专业软件开发提供实践层面的经验法则。关于这些 methodology 的书和文章多到数不清,不过其中有几种尤其值得关注:Scrum、Unified Process、Rational Unified Process、Extreme Programming 和 Software Triage。
agile model 只是高层基础;它并没有明确规定,在现实里到底该怎样落地。而这正是 Scrum 发挥作用的地方。Scrum 是一种 agile methodology,对日常如何执行给出了相当明确的说明,也是业界最常见的软件工程 methodology 之一。
Scrum 是一个 iterative process。在 Scrum 中,每一轮迭代叫作一个 sprint cycle。sprint cycle 是整个 Scrum process 的核心。sprint 的长度应当在项目开始时确定,通常为两到四周。每个 sprint 开始之前,团队会决定 sprint goals,并承诺在 sprint 结束时交付这些目标。在每个 sprint 结束时,理想状态是:软件已有一个“真正可运行、已经测试、并代表客户需求一个子集”的可用版本。Scrum 认识到客户在开发过程中很可能不断改变想法,因此它允许每个 sprint 的结果都被交付给客户。这样,客户就能看到软件的迭代版本,并向开发团队反馈潜在问题。
Scrum 中有三种角色。第一种是 product owner,它是客户与团队之间的连接点。product owner 会根据客户输入编写高层 user stories,为每个 user story 分配优先级,并把它们放进 Scrum 的 product backlog。实际上,团队中任何人都可以往 product backlog 里写高层 user story,但 product owner 负责决定哪些保留、哪些移除。
第二种角色是 Scrum master。他负责让流程真正跑起来。Scrum master 可以属于团队的一部分,但不被视为团队 leader,因为在 Scrum 中,团队是自组织的。Scrum master 更像是团队的对外联系人,让其他成员可以专注在自己的任务上。他还要确保团队正确遵循 Scrum process,例如组织下一节会讲到的 daily Scrum meeting。Scrum master 和 product owner 应由两个人分别担任。
第三种也是最后一种角色,就是 team 本身。team 负责实际开发软件,而且团队规模通常应保持较小,最好少于 10 人。
每个 sprint cycle 开始之前,都会先举行一次 sprint planning meeting。团队成员需要在会上决定:在新的 sprint 中究竟要实现哪些产品 feature。这些内容会被正式整理成 sprint backlog。候选 feature 来自按优先级排序的 product backlog;其中的 user story 都是新 feature 的高层 requirement。随后,团队会把这些高层 user story 拆解成更小的 task,并为它们做 effort estimation,再把这些 task 放入 sprint backlog。sprint planning meeting 的时长取决于 sprint 长度和团队规模;通常来说,每两周 sprint 大概需要两到四小时的 sprint planning。这个 meeting 一般会分成两部分:一部分是 product owner 与 team 一起讨论 product backlog 的优先级;另一部分则只有 team,负责最终完善 sprint backlog。
在 Scrum 团队里,你有时会看到一个实体板,也就是 Scrum board 或 sprint board,上面通常分为三列:To Do、In Progress 和 Done。每个 sprint 里的 task 都会写在一张小纸条上,再贴到对应列中。task 并不会在会议上被指派给具体某个人;相反,每个团队成员都可以自己走到 board 前,从 To Do 中挑一项 task,把它移到 In Progress。做完之后,再把它移到 Done。这种方式能让团队成员非常直观地看到:还有哪些工作没做、哪些工作正在做、哪些已经完成。除了实体板,你当然也可以用软件来维护虚拟 Scrum board。
当然,To Do、In Progress 和 Done 这三列并不是不可更改的。团队完全可以加入更多列,以反映更多步骤。例如,一个 Scrum board 可以包含:
- To Do: 当前 sprint 中计划要做、但尚未开始的任务
- In Progress: 当前正在某个 development branch 中由开发者处理的任务(见本章后面的“Version Control”)
- In Review: 已实现、正在等待其他团队成员 review 的任务,也就是 code review
- In Testing: 已实现并完成 code review,但仍在等待 QA 团队测试批准的任务
- In Integration: 已通过 code review 和 QA 批准、可以从 development branch 合回主代码库的任务,当然前提是该分支上的所有测试都已成功
- Done: 已经完整实现、review、测试并集成完毕的任务
一般建议把单个 task 保持得足够小。这样做的直接好处,是 development branch 的生命周期也会更短。
有时,团队每天还会维护一张 burn-down chart:横轴表示 sprint 的天数,纵轴表示剩余开发工时。它能够快速展示当前进展,并帮助团队判断:原计划中的 task 是否大概率能在 sprint 结束前做完。
Scrum process 还强制要求每天召开一次会议,通常叫 daily replanning、daily Scrum 或 daily standup。在这个 meeting 中,所有团队成员会和 Scrum master 一起站着开会。这个会应当每天在固定时间、固定地点开始,而且通常不应超过 15 分钟。开会时,sprint board 应对所有团队成员可见。团队会围绕当前 sprint goal 的进展进行讨论,也会讨论是否存在阻塞点或延期风险。必要时,团队甚至可以在当前 sprint 中移除任务或加入任务,以确保 sprint goal 最终能够实现。
这类 daily meeting 通常会要求每个团队成员回答三个问题:
- 昨天你做了什么,以帮助团队实现 sprint goal?
- 今天你会做什么,以帮助团队实现 sprint goal?
- 你是否看到了任何阻碍你或团队实现 sprint goal 的障碍?
当一个 sprint cycle 结束后,通常还会有两个 meeting:sprint review 和 sprint retrospective。sprint review 的时长同样取决于 sprint 长度与团队规模,一般来说每两周 sprint 需要大约两小时。在 sprint review 中,团队会做一个 demo,向 product manager、support engineer 等相关 stakeholder 展示这次 sprint 的成果,以及软件当前状态。sprint review 还会回顾这次 sprint:哪些任务完成了、哪些没有完成、原因是什么。sprint retrospective 则通常每两周 sprint 需要约一个半小时,它给团队机会反思:上一个 sprint cycle 究竟执行得如何。比如,团队可以识别流程中的不足,并在下个 sprint 里加以调整。像 “What went well?”、“What could be improved?”、“What do we want to start, continue, or stop doing?” 这类问题都会在其中被讨论。这就是所谓的 continuous improvement:也就是说,每个 sprint 结束后,连流程本身都会被检查和改进。
Scrum 的优点
Section titled “Scrum 的优点”Scrum 对开发过程中冒出来的各种意外问题具有较强韧性。问题出现后,通常都可以在后续某个 sprint 中处理掉。团队会参与项目的每一个环节:他们与 product owner 一起讨论 product backlog 中的 user story,再把这些 story 拆成更小的 task,并纳入 sprint backlog。团队还会借助 Scrum board,自主分配工作。通过这个 board,很容易看出每个成员当前在做什么;而 daily Scrum meeting 又能保证所有人都清楚 sprint goal 当前推进到了哪一步。
对于 stakeholder 来说,每个 sprint 后的 demo 是一个巨大优势,因为它能让他们持续看到项目的最新迭代版本。stakeholder 因而能很快判断项目是否正朝着正确方向发展,并据此调整 requirement;这些新需求通常又可以被纳入未来的 sprint。
Scrum 的缺点
Section titled “Scrum 的缺点”一些公司可能很难接受:由团队自己决定“谁做什么”,而不是由 manager 或 team lead 把任务分派给个人。因为在 Scrum 中,成员通常是从 Scrum board 上自己领取任务的。
Scrum master 也是保持团队不偏航的关键人物。因此,Scrum master 必须真正信任团队。对团队成员进行过度控制,通常会直接破坏整个 Scrum process。
Scrum 还可能带来一个常见问题:feature creep。因为 Scrum 允许在开发期间不断向 product backlog 加入新的 user story,project manager 就可能不断往里塞 feature。解决这个问题的一个有效办法,是尽早明确最终发布日期,或者明确最后一个 sprint 的结束时间。
Unified Process(UP)是一种 iterative、incremental 的 software development process。UP 不是一套写死的流程;它更像一个框架,需要你根据具体项目需求去定制。按照 Unified Process,一个项目通常可以分成四个 phase:
- Inception: 这个 phase 通常很短。它包括 feasibility study、business case、决定项目是内部开发还是购买第三方解决方案、给出成本和时间线的粗略估计,以及界定范围。
- Elaboration: 大多数 requirement 会在这一阶段被文档化。风险因素会被处理,system architecture 会被验证。为了验证 architecture,系统核心中最关键的部分会被构建成一个可执行交付物,用于证明该 architecture 的确能够支撑整个系统。
- Construction: 所有 requirement 都会在 elaboration 阶段交付的那个可执行 architecture 基础上被实现出来。
- Transition: 产品被交付给客户,随后来自客户的反馈会在后续 transition iteration 中被处理。
所有 phase 都会被拆分成带时间边界的 iteration,并且每次 iteration 都应产出一个可见结果。在每次 iteration 中,团队会同时推进项目中的多个 discipline:business modeling、requirements、analysis and design、implementation、testing 和 deployment。每种 discipline 在不同 iteration 中所占的工作比重会发生变化。图 28.6 展示了这种“迭代且重叠”的开发方式。在这个例子里,inception phase 用一轮 iteration 完成,elaboration 用两轮,construction 用四轮,而 transition 则用两轮。
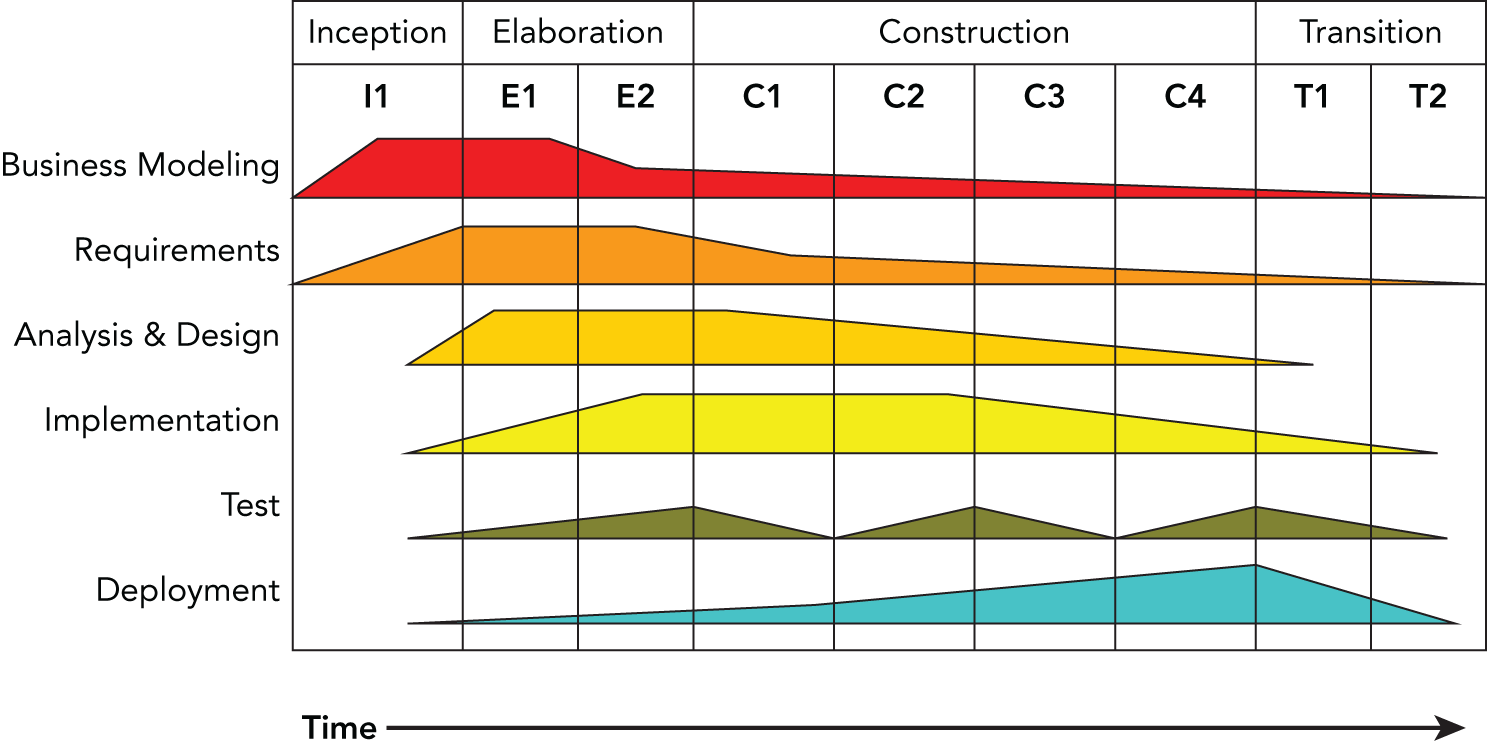
[^FIGURE 28.6]
Rational Unified Process
Section titled “Rational Unified Process”Rational Unified Process (RUP) 是 Unified Process 最知名的 refinement 之一。它是一种纪律性强、形式化程度高的软件开发过程管理方法。RUP 最重要的特点在于:与 spiral model 或 waterfall model 不同,它并不只是一个理论上的 process model。RUP 实际上还是一个由 IBM 旗下 Rational Software 出售的软件产品。把 process 本身也当作软件产品,会带来一些很有意思的优势:
- process 本身可以像软件产品一样持续更新与改进
- RUP 不只是告诉你一个开发框架,还会配套提供一整套围绕该框架工作的工具
- 作为产品,RUP 可以在整个工程团队中统一推广,从而让所有成员使用完全一致的流程与工具
- 像很多软件产品一样,RUP 也能根据使用者需求定制
作为产品的 RUP
Section titled “作为产品的 RUP”作为产品时,RUP 体现为一整套软件应用,它们会引导开发者走过软件开发流程。该产品还会对其他 Rational 产品给出具体指导,例如可视化建模工具 Rational Rose,以及配置管理工具 Rational ClearCase。RUP 还包含大量 groupware communication tools,形成一种“ideas marketplace”,方便开发者共享知识。
RUP 背后的一个基本原则,是开发周期中的每一次 iteration 都必须有 tangible result。在 Rational Unified Process 中,用户会产出大量 design、requirement document、report 与 plan。RUP 软件则提供了创建这些 artifact 所需的可视化和开发工具。
作为流程的 RUP
Section titled “作为流程的 RUP”准确定义模型,是 RUP 的核心原则。按照 RUP 的观点,model 有助于解释软件开发过程中的复杂结构与关系。在 RUP 中,model 往往会用 Unified Modeling Language(UML)的形式表达;见附录 D“UML 简介”。
RUP 把流程中的每一部分都定义为独立的 workflow(在前面对 Unified Process 的讨论中,它对应的是 discipline)。workflow 描述的是:谁负责这个步骤、正在执行哪些 task、这些 task 会产出哪些 artifact 或结果,以及推动这些 task 发生的事件顺序。几乎所有 RUP 细节都可以定制,但它仍然“开箱即用”地提供了若干 core process workflow。
这些 core process workflow 与 Waterfall Model 的阶段有些相似,但每一个都更具迭代性,也定义得更细。Business modeling workflow 用于建模 business process,通常目标是推动软件 requirement 的形成。Requirements workflow 则通过分析系统中的问题并反复修正假设,来形成 requirement 定义。Analysis and design workflow 关注 system architecture 和 subsystem design。Implementation workflow 涵盖软件 subsystem 的建模、编码与集成。Testing workflow 则对软件质量测试的规划、实施与评估进行建模。Deployment workflow 提供的是一个更高层视角,用来统筹 planning、releasing、supporting 和 testing。Configuration management workflow 则覆盖了从新项目立项,到 iteration,再到产品结束场景的整个链路。最后,environment workflow 负责通过开发工具的创建与维护来支持工程组织。
实践中的 RUP
Section titled “实践中的 RUP”RUP 主要面向大型组织。相较于传统 life cycle model,它提供了不少优势。一旦团队跨过了使用这些软件工具的学习曲线,所有成员就都能在同一平台上进行 design、交流和实现。流程可以根据团队需求进行裁剪,而每个阶段又都会产出大量有价值的 artifact,用于记录开发的各个阶段。
不过,像 RUP 这样的产品,对某些组织来说也可能过于 heavyweight。那些开发环境差异很大、或者工程预算吃紧的团队,未必愿意、也未必能够把整个开发系统标准化为某个软件产品。学习曲线本身也是成本之一:新工程师不仅要快速理解产品和现有代码库,还得同时学会使用这套流程软件。
很多年前,我有个朋友下班回家,告诉妻子他们公司采用了 Extreme Programming 的一些原则。她开玩笑说:“希望你上班记得系安全绳。”尽管名字听起来多少有点戏剧化,但 Extreme Programming (XP) 确实很有效地把其他软件开发指南中的精华打包到了一起,并加入了一些新的内容。
XP 由 Kent Beck 在 Extreme Programming Explained(Addison-Wesley, 1999)中推广。它声称要把优秀软件开发中的最佳实践“再往前推一档”。比如,大多数程序员都会同意:测试是好事。而在 XP 里,测试被视为好到一种“你甚至应该在写代码之前先写测试”的程度。
XP 的理论基础
Section titled “XP 的理论基础”XP methodology 由十二条指导原则组成,并分成四个类别。这些原则贯穿整个软件开发过程,也会直接影响工程师每天的实际工作。
类别 1:细粒度反馈
Section titled “类别 1:细粒度反馈”XP 在 coding、planning 和 testing 上给出了四条粒度很细的指导原则。
XP 建议:所有 production code 都应当由两个人并肩工作来完成,这种技术叫 pair programming。当然,真正控制键盘的人一次只能有一个;另一个人则负责审视同伴正在编写的代码,并以更高视角思考测试、必要的 refactoring,以及整个项目模型等问题。
举个例子:如果你负责为应用中的某个功能编写 user interface,那么最好能请这个功能的原作者跟你一起坐下来做。他可以提醒你该功能的正确用法、警告你注意其中的各种 “gotcha”,并在更高层面上帮助你把控方向。即便找不到原作者,只要拉来团队里的另一个成员,也常常会有帮助。它背后的理论是:两人协作可以形成共享知识,促进正确 design,并建立一套非正式的制衡机制。
在 Waterfall Model 中,planning 通常只在一开始发生一次;在 spiral model 中,planning 则是每次 iteration 的第一阶段。而在 XP 中,planning 根本不只是某个阶段,而是一项永无止境的任务。XP 团队通常从一个粗略计划开始,用它抓住产品的主要方向。在整个过程中的每一次 iteration 里,都会举行 planning game meeting。随着开发推进,计划会被不断细化、不断修订。它的出发点是:环境一直在变化,新信息也一直在出现。planning process 主要包含两部分:
- Release planning: 由开发者与客户共同进行,目标是决定哪些 requirement 要进入接下来的哪些版本。
- Iteration planning: 只由开发者参与,用来规划开发者在当前 iteration 中要做的具体 task。
在 XP 中,某个 feature 的工作量估计,总是由真正实现该 feature 的人来给出。这能避免一种常见情况:实现者被迫遵守一个完全不现实的人为进度安排。刚开始时,这种估计通常会比较粗,可能是按“周”来估某个 feature。随着时间范围缩短,估计会越来越细。最终,feature 会被拆成单个耗时不超过五天的 task。
按照 Extreme Programming Explained 的说法,“任何没有自动化测试支撑的程序功能,实际上就等于不存在。” XP 对测试几乎可以说是执着。作为 XP 工程师,你的职责之一就是为自己的代码编写配套 unit test。unit test 通常是一小段代码,用来确保某个独立功能能够正确工作。例如,对于一个基于文件的 object store,单独的 unit test 可能会包括 testSaveObject、testLoadObject 和 testDeleteObject。
XP 甚至比一般的 unit testing 更进一步:它主张在写实际代码之前,先把 unit test 写出来。当然,在代码尚未实现时,这些测试肯定是过不了的。理论上讲,如果测试足够完整,那么一旦所有测试都通过,你也就应该知道代码已经完成了。不过,真正困难的地方在于:你很难确定自己的测试是否真的“足够完整”。你必须提前设想各种可能在实现中引入的 bug,并判断测试是否真能抓住它们。写出好的测试,往往比写出好的代码还更难。在代码之前先写测试的这个过程,叫作 test-driven development(TDD)。我说过了,这确实很“extreme”。
由于 XP 强调不断细化产品计划,只构建当前真正需要的东西,因此让客户参与流程会非常有价值。虽然不一定总能说服客户在开发期间 physically 在场,但“工程团队与最终用户之间应当保持沟通”这一理念本身无疑是有价值的。客户不仅能协助单个 feature 的设计,还能通过表达自身需求,帮助团队安排 task 的优先级。
类别 2:持续过程
Section titled “类别 2:持续过程”XP 倡导:subsystem 应不断集成,以便尽早暴露 subsystem 之间的不匹配;代码在必要时应及时 refactor;同时,还应持续构建并部署小而渐进的 release。
所有程序员都熟悉集成代码这件苦差事。一旦你发现:你心目中的 subsystem 与它实际写出来的样子完全对不上,这件事就会迅速演变成噩梦。当 subsystem 汇合时,问题必然会被暴露。XP 认识到了这一点,因此主张在开发过程中频繁把代码集成回项目。
开发过程中,工程师应在 check in 代码前先运行所有测试。另外,还应有一台指定机器持续运行自动化测试。一旦自动化测试失败,团队就应收到邮件,指出问题,并列出最近一次 check-in。
如果项目使用 development branch,推荐把流程设置成:某个 development branch 只有在其上所有测试都成功通过时,才允许 merge 回主代码库。
在必要时重构
Section titled “在必要时重构”大多数程序员都会不时 refactor 代码。所谓 refactoring,就是对现有、可工作的代码重新设计,以吸收新知识、新的上游 API,或者代码写成之后才逐渐发现的替代用途。Refactoring 很难被纳入传统软件工程排期,因为它的成果不像“实现了一个新 feature”那样显眼。但优秀的 manager 会意识到:对代码的长期可维护性而言,这件事非常重要。
XP 中更“极端”的做法是:在开发过程中,一旦识别出 refactor 的时机,就当场去做。也就是说,XP 程序员不会在 release 一开始就预先决定“产品中哪些已有部分需要设计工作”,而是会在日常开发中学习如何识别那些已经“准备好该 refactor 了”的代码气味。虽然这种做法几乎肯定会引入意外的、未排期的任务,但在适当时机调整代码结构,往往能显著降低后续开发难度。
XP 的一个核心理论是:当软件项目试图一次做太多事时,就会迅速变得风险高、难以驾驭。与其搞一个动辄包含核心变更、还要附好几页 release note 的大型 release,XP 更倡导时间跨度接近两个月、而不是十八个月的小型 release。release 周期一旦足够短,真正能进产品的就只会是最重要的 feature。这会迫使 engineering 和 marketing 必须认真达成一致:哪些 feature 才是真的重要。
类别 3:共享理解
Section titled “类别 3:共享理解”软件是由团队开发出来的。任何写出的代码都不应属于某个个人,而应属于整个团队。XP 因此给出了一组原则,用来确保代码与想法能够真正被共享。
共享通用编码标准
Section titled “共享通用编码标准”由于 XP 强调 collective ownership 和 pair programming,如果团队中每个工程师都有自己完全不同的命名和缩进风格,那么在这种极端协作环境下编码会变得非常困难。XP 并不要求某种特定风格,但它会提醒你:如果你只看一段代码,就能立刻猜出作者是谁,那么你的团队大概率需要重新定义自己的 coding standard。
关于 coding style 的更多讨论,可见第 3 章“代码风格”。
在很多传统开发环境中,代码所有权会被严格划分,甚至被明确强制执行。我有个朋友以前就在这样一个环境里工作:manager 明文禁止你 check in 任何其他团队成员所写代码的修改。XP 则走向了几乎完全相反的方向:它宣称,代码由所有人共同拥有。
collective ownership 在实践中有不少现实意义。从管理角度看,当某个工程师突然离开时,损失会小得多,因为总还有其他人理解那部分代码。这会提升项目的 bus factor 或 bus number,也就是“最少要有多少工程师被公交车撞到,项目才会真正停摆”。从工程师角度看,collective ownership 会帮助团队建立对系统工作方式的共同理解。这有助于 design 工作,也让个人工程师更有自由去做那些能提升整个项目价值的改动。
需要强调的一点是:collective ownership 并不意味着每个程序员都必须熟悉每一行代码。它更像是一种心态:这个项目是整个团队共同的努力,没有理由让任何一个人囤积知识。
XP 工程师经常挂在嘴边的一句 mantra 是 “avoid speculative generality”,也就是常说的 KISS——“Keep It Simple, Stupid”。这和许多程序员的天然倾向正好相反。比如,假设你接到的任务是设计一个基于文件的 object store,那么你很可能会不由自主地朝“打造一个一统天下的、终极的 file-based storage 方案”那个方向走。你的 design 很快也许就会开始覆盖多种语言、支持任意对象类型。XP 则主张你要往“更具体、更克制”的那一端靠。不要去设计一个能拿奖、能让同行赞不绝口的完美 object store,而应当去设计“那个最简单、但已经足够完成任务”的 object store。你要理解当前 requirement,并严格按这些 requirement 来写代码,避免设计复杂化。
在 design 上真正习惯“简单”,其实并不容易。根据你的工作类型不同,代码可能要存活很多年,并被你现在根本想象不到的其他部分复用。正如第 6 章“面向复用设计”所讨论的,把那些“也许将来会有用”的功能提前做进去,问题在于:你其实根本不知道那些假设用例究竟是什么,也没有办法仅凭猜测就设计出真正好的结构。实际上,你为了某个永远可能不会发生的假设场景提前做设计,反而有可能把另一个后来真实出现、且更有价值的场景卡死,除非你再把整套 design 重构一遍。XP 的观点是:先把今天真正需要的东西做好,同时给未来修改保留空间。
共享共同隐喻
Section titled “共享共同隐喻”XP 使用 metaphor 这个词,指的是团队所有成员(包括客户和 manager)都应共享对系统的某种共同高层理解。它并不是指对象之间将如何通信、或者精确的 API 会长什么样。metaphor 更像是整个系统组件的 mental model 与 naming model。每个组件都应有一个足够有描述性的名字,使团队成员仅仅看名字就能大致猜出其职责。团队在讨论项目时,也应借助这一 metaphor 来维持共享术语。
类别 4:程序员福祉
Section titled “类别 4:程序员福祉”XP 的最后一组原则,关注的是开发者本身的福利。
合理安排工时
Section titled “合理安排工时”对于你一直以来投入的工时,XP 也有话要说。它的观点是:休息充分的程序员,才会是开心而高效的程序员。XP 倡导大约每周 40 小时的工作时长,并明确警告:不要连续两周以上长期加班。
当然,不同的人需要的休息量并不相同。但它的核心思想是:如果你在头脑不清醒的状态下坐下来写代码,那么你写出的很可能就是糟糕代码,而且你也很难坚持 XP 的那些原则。
实践中的 XP
Section titled “实践中的 XP”XP 的纯粹主义者会认为:Extreme Programming 的这 12 条原则彼此高度缠绕,如果你只采纳其中一部分,而不同时采纳其余部分,那么整个 methodology 就会被严重削弱。比如,pair programming 对测试就非常重要,因为如果你不知道怎么测试某段代码,你的搭档可以帮助你。而且,如果你某天累了,想偷懒不写测试,你的搭档也能立刻让你感到应有的羞耻感。
不过,XP 的一些 guideline 在实践中确实可能难以实施。对某些工程师来说,“在代码之前先写测试”这个想法过于抽象。对这些人而言,也许只要先设计测试,而不必真的在有代码之前把测试全部写出来,就已经足够了。XP 的许多原则都被定义得很严格,但如果你真正理解其背后的理论,往往仍有机会把这些 guideline 调整成更适合自己项目的形式。
XP 的协作面向同样可能很具挑战性。pair programming 的确有可量化的收益,但从 manager 的角度看,很难不去怀疑:“为什么每天真正写代码的人少了一半?”团队中的一些成员甚至会对如此近距离的合作感到不舒服,比如他们可能很难在别人盯着看的情况下打字。XP 天然就更适合某些性格;尤其是 introvert,往往会更讨厌 pair programming。如果团队地理上非常分散,或者很多成员长期远程办公,那么 pair programming 的现实障碍也会非常明显。
对于某些组织来说,Extreme Programming 可能还是过于激进。那些已经建立了严格工程政策的大型成熟公司,往往很难快速接受 XP 这样的方式。不过,即便你的公司对 XP 持保留态度,你依然可以通过理解其背后的理论,提升自己的个人生产力。
在 Edward Yourdon 那本名字就很悲观的书 Death March(Prentice Hall, 1997)中,他描述了一种软件项目中经常出现且相当可怕的现象:项目已经严重落后于计划、人员不足、超出预算,或者 design 一团糟。Yourdon 的理论是:当软件项目进入这种状态时,即便是最好的现代软件开发 methodology,也已经不再适用。正如本章前面所看到的,许多软件开发方法都建立在形式化文档、或以用户为中心的 design 方法之上。而对于一个已经进入 “death march” 模式的项目来说,通常根本已经没有时间按这些方法继续做了。
Software Triage 背后的思想是:当项目已经处于糟糕状态时,资源本身就已经非常稀缺。时间稀缺,工程师稀缺,金钱也可能同样稀缺。此时,manager 和 developer 首先需要跨过的一道心理门槛,是承认:在规定时间内,原始 requirement 已经不可能全部满足。接下来的任务,不再是“尽量全部做完”,而是把剩余功能整理成 must-have、should-have 和 nice-to-have 三类。
Software Triage 是一个艰难、敏感、且经常伴随着痛苦取舍的过程。很多时候,它需要一位真正见过 “death march” 项目的外部老兵来做艰难决策。对工程师来说,最重要的认识是:在某些条件下,为了按时完成项目,你可能必须把熟悉的流程——甚至连一部分现有代码——一起扔出窗外。
构建适合自己的流程与方法论
Section titled “构建适合自己的流程与方法论”几乎不可能有哪一本书、哪一种工程理论,能够完美匹配你的项目或组织需求。我建议你尽可能从不同方法中学习,然后自己设计适合你的流程。把不同方法中的概念揉在一起,往往比你想象得更容易。例如,RUP 就可以选择性地支持一种类似 XP 的工作方式。下面是一些帮助你构建“理想软件工程流程”的建议。
对新想法保持开放
Section titled “对新想法保持开放”有些工程技术第一次听上去会显得很疯狂,或者看起来根本不可能奏效。面对软件工程 methodology 中的新想法,不妨把它们视为“精炼现有流程”的机会。能试的时候就去试试看。如果 XP 听起来很有趣,但你又不确定它是否适用于自己的组织,那就看看能否循序渐进地引入:比如一次只尝试其中几条原则,或者先在一个较小的试点项目里实验。
把新想法带进团队讨论
Section titled “把新想法带进团队讨论”你的工程团队大概率由背景非常不同的人组成。团队里可能同时有 startup veteran、长期 consultant、刚毕业的新人,以及 PhD。每个人对“软件项目该如何运作”都可能有不同经验和不同看法。很多时候,最好的流程恰恰是把这些截然不同环境中“各自有效的做法”拼接在一起的结果。
识别哪些做法有效、哪些无效
Section titled “识别哪些做法有效、哪些无效”在项目结束后——最好甚至是在项目进行过程中,比如像 Scrum 的 sprint retrospective 那样——把团队聚到一起,认真评估流程。有时,某个重大问题会一直没人意识到,直到整个团队真正停下来思考。也有时候,存在一个“每个人都知道、却没人真正说开”的问题。
想想哪些地方运转得不好,再思考如何修复它们。有些组织会要求在任何 source code check-in 之前,先做正式 code review。如果 code review 长到又臭又闷,导致根本没人认真审,那就应该作为团队一起重新讨论 code review 的方法本身。
同样,也要看看哪些地方运转得很好,并思考是否可以把这些成功经验扩大。例如,如果把 feature task 维护在一个可多人编辑的 wiki 上效果不错,那么也许就值得再投入一些时间,把这个网站本身做得更好。
不要独行其是
Section titled “不要独行其是”无论流程是 manager 强制规定的,还是由团队自己设计出来的,它既然存在,就总有原因。如果你的流程要求编写正式 design document,那就请认真写。如果你觉得这个流程已经坏掉了,或者复杂得离谱,那就去和 manager 讨论。不要只是绕开流程走捷径——它迟早会反过来咬你。
对任何公司来说,无论规模大小,管理全部 source code 都非常重要;哪怕是单人项目,也是如此。举个例子,在公司环境里,如果所有 source code 都只是散落在各个开发者自己的机器上,而没有由任何 version control 软件统一管理,那几乎一定会演变成维护噩梦,因为没有人能保证自己手里的总是最新代码。相反,所有 source code 都必须 由 version control software 来管理。此类软件大致可以分成三类:
- Local: 这类方案把全部 source code 文件及其历史都保存在本地机器上,并不真正适合团队使用。它们属于 70/80 年代的方案,今天已经不应再使用,因此本书不再讨论。
- Client/server: 这类方案由 client component 和 server component 两部分组成。对个人开发者而言,client 和 server 完全可以运行在同一台机器上;但这种分离方式也让你在需要时,可以很方便地把 server component 迁移到独立物理服务器上。
- Distributed: 这类方案比 client/server 更进一步。它不依赖一个“所有东西都集中存放”的中心位置。每个开发者手里都有全部文件以及全部历史记录的副本。它采用的是 peer-to-peer 模式,而不是 client/server 模式,代码通过交换 patch 在各 peer 之间同步。
client/server 方案由两部分组成。第一部分是 server software,它运行在中心 server 上,负责追踪全部 source code 文件及其历史。第二部分是 client software,它安装在每位开发者机器上,负责与 server software 通信,以获取某个 source file 的最新版本、获取更早版本、把本地修改提交回 server、把修改回滚到之前版本,等等。
distributed 方案则不依赖中心 server。client software 通过 peer-to-peer 协议与其他 peer 同步,并通过交换 patch 来同步代码。像提交修改、回滚修改这类常见操作都非常快,因为它们不需要通过网络访问中心 server。缺点则是:client 机器需要更多空间,因为它必须保存所有文件以及完整历史。
大多数 version control system 都有一套自己的术语;遗憾的是,不同系统使用的词并不完全统一。下面列出一些最常见的术语:
- Branch: source code 可以被 branched,也就是并行发展出多个版本。例如,可以为每一个已发布版本维护一个 branch。在这些 branch 上,可以实现对应 release 的 bug fix;与此同时,新 feature 则继续加到主 branch(通常称为 trunk)中。为已发布版本写出的 bug fix,之后也可以 merge 回主 branch。
- Check out: 在开发者本机上创建一份本地副本,这份副本可以来自中心 server,也可以来自 peer。
- Check in / commit / merge / push: 开发者先在本地副本上做修改。当本地机器上一切正常之后,就可以把这些本地修改 check in / commit / merge / push 回中心 server。
- Conflict and resolve: 当多个开发者对同一个 source file 做了相互重叠的修改时,提交该文件时就可能发生 conflict。version control software 通常会尝试自动 resolve;如果做不到,就会要求用户手动解决这些 conflict。
- Label or tag: 某个时间点上,可以给全部文件、或某个特定 commit 加上人类可读的 label / tag。这使得回到当时那一版 source code 变得非常方便。
- Repository: 由 version control software 管理的全部文件集合,以及它们的历史记录。它还包括每个 commit 的元数据,例如提交时间、提交者,以及可能附带的 commit message(解释为什么做这次修改)。
- Revision or version: revision(或 version)是某个文件在特定时间点内容的快照。它代表一个可以被回退、或被拿来比较的历史点。
- Update or sync: update / sync 表示将开发者机器上的本地副本,与中心 server 上或 peer 上的某个版本同步。要注意,这实际上意味着把上游代码 merge 进本地工作副本,而这可能会引入需要手动解决的 conflict。
- Working copy: 开发者个人机器上的本地副本。
目前可用的 version control software 方案有很多,有些是 free/open-source,有些是 commercial。下面的表格列出其中一些代表:
| FREE/OPEN-SOURCE | COMMERCIAL | |
|---|---|---|
| Local Only | SCCS, RCS | PVCS |
| Client/Server | CVS, Subversion | IBM Rational ClearCase, Azure DevOps Server, Perforce |
| Distributed | Git, Mercurial, Bazaar | TeamWare, BitKeeper, Plastic SCM |
本书不会推荐某个具体软件方案。如今,大多数软件公司通常都已经有一套既定的 version control system,而每个开发者都必须遵循它。如果不是这样,公司就应当认真投入时间调研这些可选方案,并挑出一个真正适合自己的。归根结底,没有 version control system 的软件开发,必然会滑向维护噩梦。即便是个人项目,我也建议你认真研究一下现有方案。只要找到一款你喜欢的工具,它就能显著让生活轻松很多:它会自动记录不同版本以及你的修改历史,从而使你在某次改动不如预期时,能轻松回退到更早版本。
本章向你介绍了若干软件开发过程的 model 与 methodology。当然,构建软件的方法远不止这些,既有正式的,也有非正式的。说到底,也许根本不存在某一种“唯一正确”的软件开发方法;唯一真正正确的方法,往往就是最适合你团队的方法。找到它的最好办法,是你自己主动去研究,从各种方法中吸收有价值的部分,与同行讨论他们的经验,并不断迭代自己的流程。记住:评估某种 process methodology 时,唯一真正重要的指标,就是它在多大程度上帮助你的团队更好地写代码。
本章最后还介绍了 version control 的概念。它应当成为任何软件公司——无论大小——不可或缺的一部分,对在家做个人项目也同样有益。如今可用的 version control 软件方案很多,既有免费的,也有商业的。我建议你实际尝试几种,看看哪一种最适合你。
通过完成下面这些练习,你可以巩固本章讨论的内容。所有练习的参考解答都包含在本书网站 www.wiley.com/go/proc++6e 提供的代码下载包中。不过,如果你在某道题上卡住了,建议先回过头重读本章相关部分,尽量自己找到答案,再去看网站上的解答。
- 练习 28-1: 请举出一些 software life cycle model 与 software engineering methodology 的例子。
- 练习 28-2: XP 提倡 continuous integration。如果这听起来已经够极端了,那么近些年有些公司还更进一步,实践 continuous deployment。请自行做一些调研,看看 continuous deployment 究竟意味着什么。
- 练习 28-3: 除了练习 28-2 中的 continuous deployment 之外,还有 continuous delivery。请自行调研 continuous delivery,并把它与 continuous deployment 做个对比。
- 练习 28-4: 调研术语 rapid application development(RAD)。它与本章讨论的内容有什么关系?